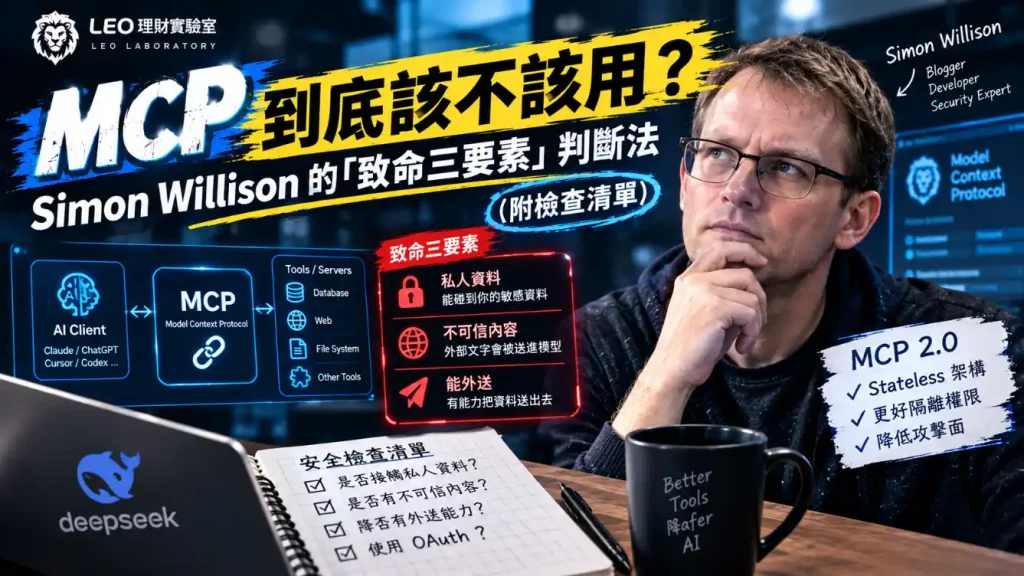
MCP 到底該不該用?Simon Willison 的「致命三要素」判斷法(附檢查清單)
你有沒有過這種經驗?看到大家在裝 MCP server,好像每個 AI 工具都在背後偷偷用不同的 MCP,你卻不確定它安不安全,也不知道自己該不該跟風裝一個?
老實說,MCP(Model Context Protocol)是 2026 年 AI 工具串接最紅的標準,市面上 MCP server 多到爆。但「大家都用」不代表「你不用想」。連寫過最經典 AI 安全文章的 Simon Willison,都對 MCP 抱過很深的質疑——只是後來他又因為 MCP 2.0 重新燃起興趣。這中間的轉折,其實就是「MCP 到底該不該用」的最佳解答。
這篇文章用 Simon 的「致命三要素」當判斷主軸:有的 MCP 完全安全、有的 MCP 一裝上去就危險,差別只在三件事是否同時湊齊。看完你就能自己判斷,不用再靠感覺。
MCP 是什麼?為什麼每個 AI 工具都在推它?
MCP 是 Anthropic 在 2024 年 11 月提出的開放標準,用來統一「AI 模型怎麼呼叫外部工具」。2025 年 12 月,Anthropic 把它捐給 Linux 基金會旗下的 Agentic AI Foundation(AAIF),AWS、Google、Microsoft、OpenAI 都是創始會員(來源:MCP 官方網站、Anthropic 捐贈公告)。
用白話講:以前你要讓 AI 串一個資料庫、瀏覽器或通訊軟體,每家工具都用自己的格式,麻煩。有了 MCP,廠商只要實作一個 MCP server 介面,就能一次餵給 Claude、ChatGPT、Codex、Cursor 等一堆 AI 客戶端。這就是為什麼 2026 年一堆工具都搶著標榜「支援 MCP」。
Simon Willison 為什麼質疑 MCP?(致命三要素)
Simon Willison 是知名的 AI 部落客兼開發者。他在 2025 年 4 月寫了一篇〈Model Context Protocol has prompt injection security problems〉,點出 MCP 最大的痛點:Prompt Injection(提示注入)——惡意駭進你 server 看到的文字裡,騙 AI 去執行壞事。
他把最危險的情境叫「致命三要素(lethal trifecta)」,同時具備這三樣才危險:
- 私人資料:MCP server 能碰到你的私人/敏感資料
- 不可信內容:有外部、沒有信任來源的文字會被送進你的模型(例如網頁、郵件、使用者輸入)
- 能外送:MCP server 有能力把資料送出去(網路請求、寫檔、發訊息)
Simon 的原話是:「這三樣任何兩樣你都能忍受,但三樣湊在同一個 session 裡,你就只能靠模型的判斷力——而那不是一種安全機制。」(來源:Simon Willison, April 2025)
要注意,Simon 質疑的不是「MCP 協議本身」,而是「連上 MCP server 之後的權限與資料流動」。這是很多人會搞混的地方。
什麼情況下用 MCP 很安全?(判斷準則)
判斷準則很簡單:只要「致命三要素」沒有同時湊齊,MCP 通常安全。實務上,安全的 MCP server 大多符合下面至少一種特徵:
- 只讀、不出網站:server 只幫你讀本地資料,沒有對外的寫入/發送能力
- 不碰私人資料:server 存的都是公開資料(如 MDN 文件、瀏覽器相容性資料)
- 內容可信任:進到模型的都是你或官方提供的資訊,沒有外部不可信來源
- 權限最小化:只用 OAuth 使用者授權,而不是給一個全權 API Key
Simon 後期其實很認同 MCP 的一個價值:它能「隔離 auth」。他把理想化的 MCP 形容成「一個 API 的 auth 閘道」——讓模型永遠拿不到你的 API 金鑰,金鑰由 harness 層保管。(來源:Simon Willison, June 2026)
什麼情況下 MCP 很危險?(GitHub MCP 實例)
反面案例,Simon 舉了 Github 的 MCP server——它一個工具就把三要素全湊齊了:
- server 有權限讀「私人資料」(你的私有 repo)
- 它的內容來源包含「不可信內容」(issue、PR 裡別人的留言、外部連結的內容)
- 它有「能外送」的能力(可以幫你 commit、push、發送請求)
(來源:Simon Willison, GitHub MCP 案例)
也就是說:一個看起來很正常、大家都很愛用的 MCP,只要三樣同齊,攻擊者就能把惡意文字藏在 issue 或 PR 裡,讓 AI 讀到後幫你執行原本不該做的事。
MCP 2.0(stateless)為什麼讓 Simon 重新燃起興趣?
2026 年 7 月 28 日,MCP 規範更新到 2.0(stateless 版本),這是 MCP 推出以來最大的規格變動。Simon 在 7 月 31 日寫了〈Stateless MCP has recaptured my interest〉,說這讓他「重新燃起對 MCP 的興趣」,還為此寫了 mcp-explorer(MCP server 探測工具)和 datasette-mcp(把 Datasette 透過 MCP 暴露)。
MCP 2.0 把 MCP 從「連線為中心」改成「請求為中心」——每次呼叫是一支獨立的 HTTP 請求,不需要維持長連線 session。對安全性的意義是:狀態變少、攻擊面變小、更容易用 OAuth 隔離權限。這讓「MCP 當成純 auth 閘道」這個理想化用法更接近現實。
不過要強調:stateless 解決的是「連線與權限的隔離」,它並沒有消除「三要素同齊」的本質風險。該判斷的準則還是那三樣。
我該怎麼判斷能不能用 MCP?(檢查清單)
下載帶回你的 MCP 判斷清單,上線前逐項勾:
底線: MCP 不是不能用,是你要知道自己連上的東西「有沒有外送能力、會讀到什麼內容、能不能碰私人資料」。三件事搞清楚再連,就是 Simon 那套「把 MCP 當成幫你看門的閘道」的安全用法。
常見問題 FAQ
MCP 和一般 API 金鑰哪個比較安全?
MCP 本身不是更安全,而是你把權限抽離出來、用 OAuth 隔離。關鍵在於「模型拿不拿得到你的金鑰」——MCP 做得好的話,模型連 Key 都看不到。這正是 Simon 說的「MCP 的核心價值」。
我接 MCP 前一定要看 server 原始碼嗎?
不需要逐行看,但至少要知道它是「只讀還是能寫」、連了哪些權限。GitHub MCP 看起來很正常,其實三要素全齊——不可以因為「大家愛用」就跳過判斷。
MCP 2.0(stateless)裝起來更安全嗎?
它減少連線狀態、更好隔離權限,所以比較好守。但「三要素同齊」的根本風險仍然存在,判斷準則不變。
哪個 AI 工具支援 MCP?
Claude、ChatGPT、Codex、Cursor 等主流工具在 2026 年大多支援。mcp-explorer 可以幫你探測 server 裝了哪些工具。
結語:別怕用 MCP,但要「帶著判斷」用
MCP 已經是 AI 工具串接的標準,就像你用任何 API 前會確認「權限給誰、資料去哪」,用 MCP 前只要先掃過「三要素」三個問題就好。Simon 從質疑到擁抱的轉折,恰恰說明:協議沒有錯,錯的是你不判斷就安裝。
想更深入了解 AI 串接背後的風險,推薦接著看:〈你的 API Key 被拿去賺錢了嗎?LLM Token 轉售黑市〉,以及〈Karpathy 說「畫鵜鶘」不夠了 — LLM 從玩具任務走向自主任務〉,兩篇都在講「AI 自動化的信任邊界」。
延伸閱讀
5 個省錢策略,從月費 NT$2,200 → NT$660 👇
🔒 填寫即訂閱雙週報,可隨時退訂。下載連結將寄到你的信箱。