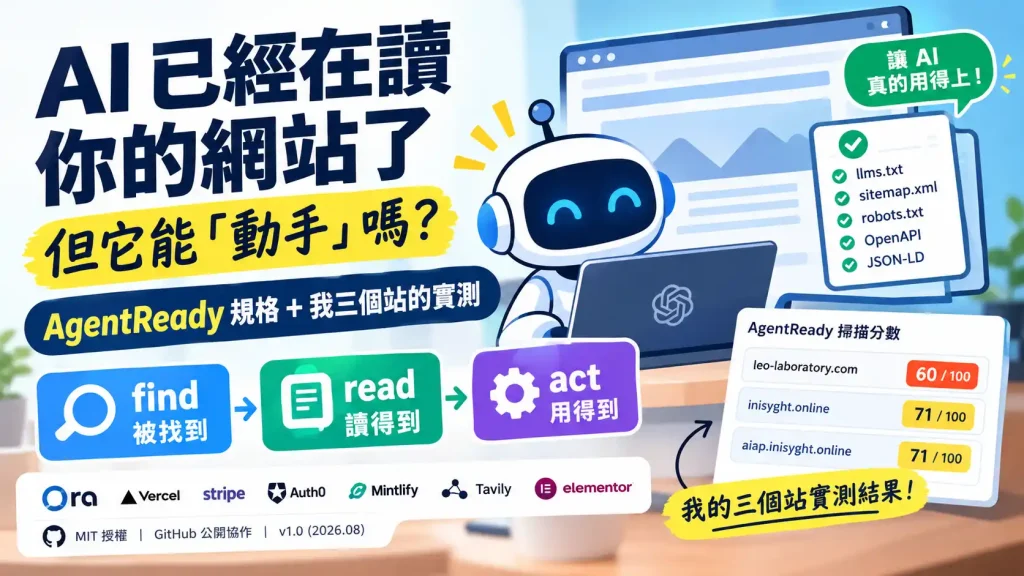
AI 已經在讀你的網站了,但它能「動手」嗎?AgentReady 規格+我三個站的實測
你有沒有發現,這半年來「AI 引用你的文章」變成一件要主動經營的事——我們開始講 GEO、講 llms.txt、講怎麼讓 ChatGPT 找到你。
但那些都在講「被讀到」。真正還沒被多數人注意到的是下一層:AI 不只要讀你的網站,它開始想「用」你的網站。
2026 年 8 月,一個叫 AgentReady 的開放規格把這件事寫成了標準。我把規格讀完,然後拿我自己三個站去掃——分數不太好看,但這正好能說明它想解決什麼問題。
AgentReady 是什麼?它跟 GEO、WebMCP 差在哪?
一句話:GEO 管「被找到」,WebMCP 管「怎麼操作」,AgentReady 管「你的產品整體準備好了沒」。
官方定義是:an open specification of what a product should implement to be usable by AI agents, from discovery to completion(一個產品要能被 AI agent 使用,該實作哪些東西——從被發現到完成任務)。
它的組成值得先講清楚,因為很多人會誤會:
- 由 Ora 主導,協作名單有 Vercel、Stripe、Auth0、Mintlify、Tavily、Elementor
- MIT 授權、GitHub 公開協作,規格原始碼與研究資料集都公開
- 最新版是 v1.0(2026 年 8 月),把結構重組成 find / read / act 三段,識別碼改成
AR-FIND、AR-READ、AR-ACT - 每條要求都有 BCP 14 的強度標記:
MUST(實測中真的弄壞 agent 的)、SHOULD(明顯影響 agent 行為的)、MAY(新興慣例)
⚠️ 一個很多人會搞錯的點:它明確不是評分框架。 官方原文:
“AgentReady names what to implement; it does not prescribe scoring, thresholds, or measurement methodology.”
它不給分、不加權、不設及格線,也不是獎章。會給分的是掃描器(後面會講),那是另一件事。
規格只有三層:find → read → act
官方把它壓縮成三句話,而且照著 agent 遇到你的順序排:
注意最後那層的括號:act 只在「你希望 agent 替你完成任務」時才需要。如果網站只是內容(像部落格),find 跟 read 顧好就夠了。
哪兩件事會直接把 agent 弄死?
這是整份規格裡最有價值的一句:
只有兩件事真的弄壞了 agent——把答案藏在 JavaScript 後面,以及封鎖它。
他們做了一個對照實驗:同一個 docs 站,用 19 種設定、5 個題目、2 種客戶端(純抓取 vs 會跑 JS),共 190 次探測。結果只有三種設定失敗,而且收斂成兩類:
他們也追蹤了 1,033 次真實 agent 執行,幾組數字值得記住:
| 觀察 | 數據 |
|---|---|
| 答案可追溯到 agent 抓過的頁面 | 82% |
| 其中答案是 docs 頁的比例 | 47%(最高,llms.txt 14%) |
| 首頁:有被造訪 | 69%(其中 92% 是第一站) |
| 首頁之後下一跳是 docs | 59% |
| docs 頁:有被讀到 | 83%,平均每趟 3.4 頁 |
| agent 答案含程式碼時,含頁面逐行原文 | 61% |
| sitemap 被直接抓取 | 只有 4% |
換句話說:docs 是最重要的頁面,首頁是入口,sitemap 主要是給爬蟲看的。
我拿自己的三個站做實測
規格說得再好,還是要看真實數據。我手上有三個站,全部跑一輪(掃描時間 2026-10-23 16:39 UTC,用 is-agentic.com 的 CLI):
| 網站 | 平台 | 分數 |
|---|---|---|
| leo-laboratory.com | WordPress + LiteSpeed | 60 / 100(重要阻礙仍在) |
| inisyght.online | Vercel | 71 / 100(可用,有明顯缺口) |
| aiap.inisyght.online | 11ty 靜態 | 71 / 100(可用,有明顯缺口) |
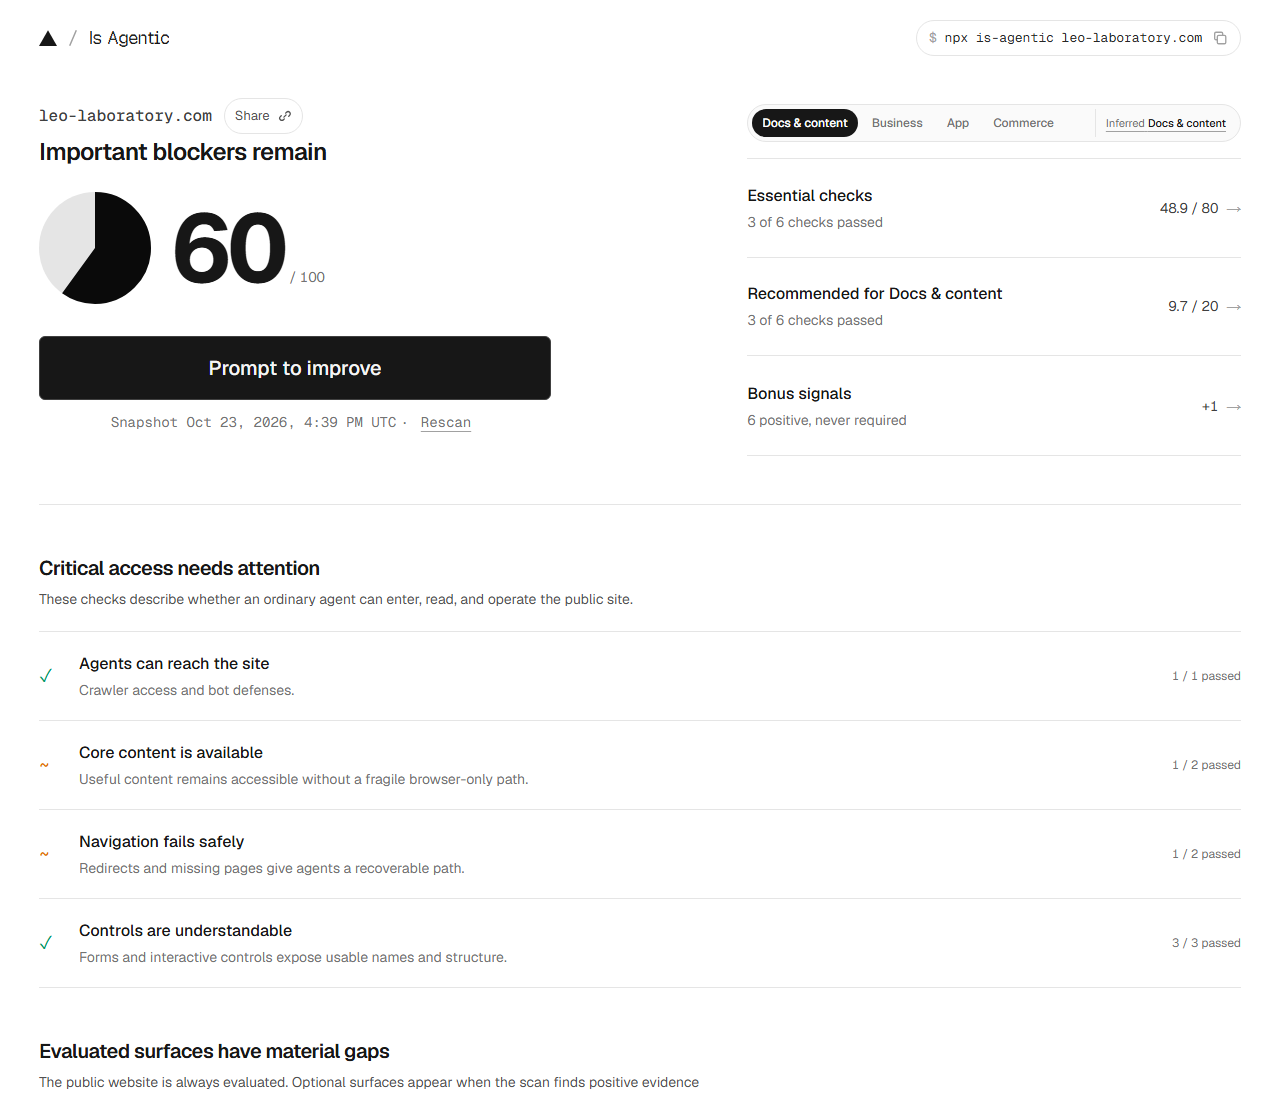
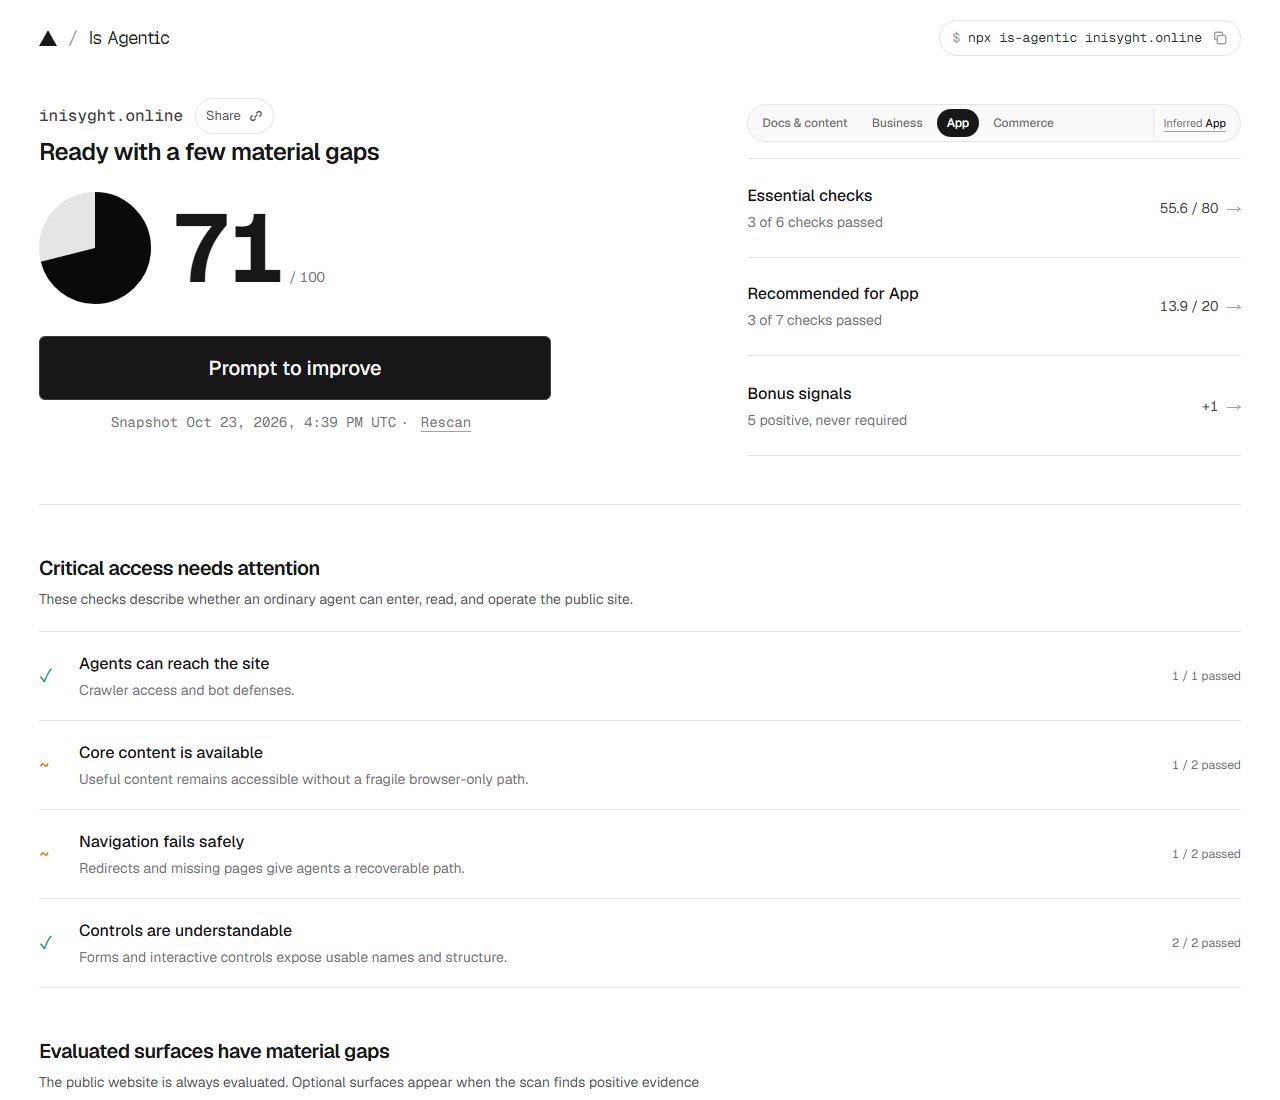
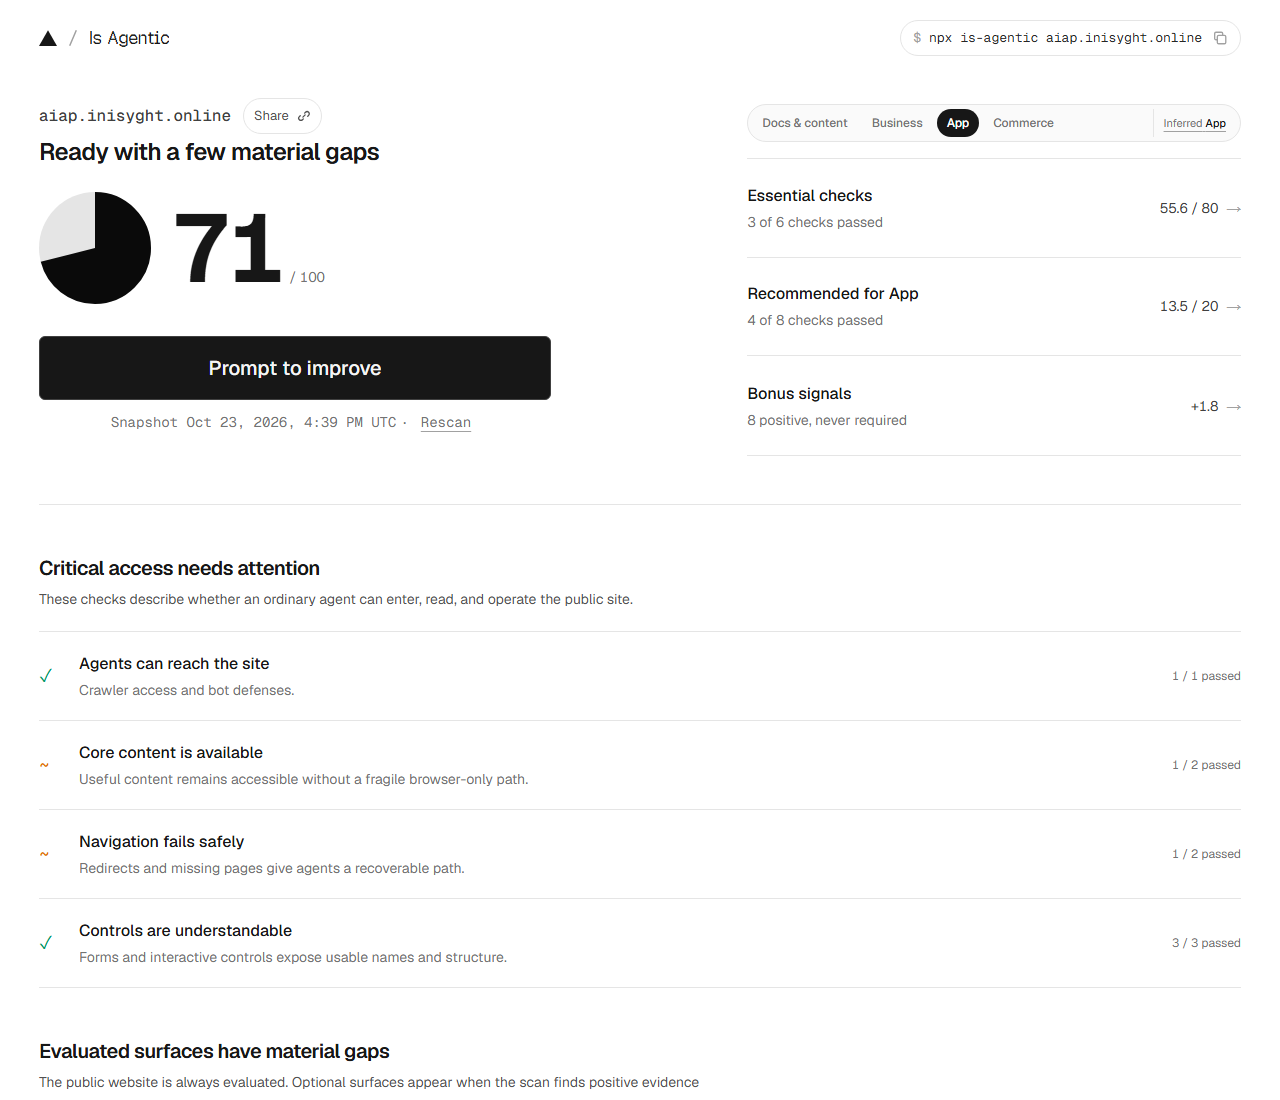
掃描當天(2026-10-23 16:39 UTC),三個站各自缺什麼:
| 檢查項 | leo-laboratory | inisyght | aiap |
|---|---|---|---|
| 首頁不是 JS 空殼 | ✅ | ✅ | ✅ |
| GPTBot/ChatGPT-User/ClaudeBot 都回 200 | ✅ | ✅ | ✅ |
| sitemap 真的存在 | ❌ 301→404 | ✅ 27 個 | ✅ 26 個 |
| llms.txt | ❌ 404 | ❌ 404 | ✅ 2,499B |
| robots.txt 有明確允許 AI 爬蟲 | ⚠️ 只有 * | ⚠️ 只有 * | ✅ 逐一點名 |
接著我把主站的洞補起來,同一個腳本再跑一次:
| 檢查項 | 掃描當天 | 現在(2026-10-24 複驗) |
|---|---|---|
| sitemap 真的存在 | ❌ 301→404 | ✅ 200,154 個 URL |
| llms.txt | ❌ 404 | ✅ 200,184 個連結(153 篇) |
| 隱私權政策頁 | ❌ 404 | ✅ 200,3,633 字 |
/about/ 找得到 | ❌ 404 | ✅ 301 → 關於我 |
/contact/ 找得到 | ❌ 404 | ✅ 301 → 關於我 |
| WordPress 範例頁 | 還在 sitemap 裡 | ✅ 已移除 |
| robots.txt 明確允許 AI | ⚠️ 只有 * | ✅ 15 個 AI 代理逐一點名 |
⚠️ 分數沒動,我不會假裝它動了。 掃描器回給我的還是 10/23 16:39 那份快照(連跑三次都一樣),它還沒重掃。所以上面那張 60 分的表是「修復前」的狀態,不是現在的結論。
第一個發現就是壞消息:我主站的 sitemap 是壞的。
robots.txt 宣告 https://leo-laboratory.com/sitemap_index.xml,但那個網址回 404;/sitemap.xml 與 /wp-sitemap.xml 都 301 導到同一個 404。也就是說,我一直在告訴 AI「我的地圖在這裡」,但那張地圖不存在。
後來我把它修好了,順便得到一個很有價值的教訓。 修法是先在 Rank Math 確認 sitemap 模組開著、再重新儲存一次永久連結(刷新 rewrite rules)。但存完之後還是 404——因為 LiteSpeed 把那個 404 頁面快取住了。
判斷方法很簡單:同一個網址加一個沒用過的參數(?nocache=123)繞過快取,回 200;不加參數就是 404。也就是說伺服器早就好了,是快取在騙人。清一次 LiteSpeed 快取之後:
順帶確認兩件事是「正確地不在裡面」:排程中未發布的文章不在、草稿不在。
第二個發現:掃描當時,三個站都卡在同樣幾件事。
text/markdown 時仍回 HTML — 三個站全數失敗這幾件都不是什麼高深技術,全部是「有沒有去做」。 補完之後,掃描器上那幾條「Sitemap exists」「trust anchor pages」的 FAIL,在真實世界已經不成立了——只剩它重掃才會反映出來。
⚠️ 兩個必須誠實說明的地方:
- 掃描器不是規格。
is-agentic.com是 Vercel × Ora 的評分器,ora.ai是另一個全量評分器,Mintlify有第三個(只掃 docs)。三個都不是 AgentReady 本體,權重也可能各自變動。 - 換 User-Agent 測不準。 官方自己提醒:阻擋器看的是來源 IP,不是 UA 字串,所以你用 curl 假裝 GPTBot 通過,不代表真的 agent 進得來。可靠做法是看伺服器日誌,並對照 OpenAI/Anthropic 公布的爬蟲 IP 範圍。
不用寫程式就能做的 3 件事
如果你想先撿「成本最低、影響最大」的,就這三件:
① 把 robots.txt 寫成「一個規則給所有 agent」,不要只點名幾家。
研究顯示:AI 爬蟲的存取是看品牌不是看政策——Google-Extended 到得了 87%、ClaudeBot 82%、ChatGPT-User 81%、DeepSeek 近 90%,但比較新的 OpenClaw 只有 59%。你如果只放行你聽過的名字,新 agent 就是被擋在門外。
② 確認 sitemap 真的打得開。
這就是我自己的翻車點。放一個 404 的 sitemap 等於沒放,而且比沒放更糟——你明明宣告了它。
③ 把 llms.txt 放在首頁原始碼看得到的地方。
規格對「AI Catalog」那條特別註明:86–100% 的這類檔案被造訪,是靠連結進去的,不是 agent 自己猜路徑。檔案放在那裡但沒有任何頁面連到它,等於不存在。
我自己是在 <head> 加一行 <link rel="alternate" type="text/plain" href="/llms.txt">——用 Code Snippets 掛 wp_head,不動主題檔案。順帶說:robots.txt 裡寫 llms.txt 路徑沒有標準語法,多數 agent 不會讀,別把力氣花在那裡。
什麼時候才需要做到 act 那一層?
很多文章會叫你去接 MCP、做 WebMCP、開 API。但規格寫得很清楚:act 只在你的產品要「完成任務」時才需要。
用這個判斷:
| 你的網站是 | 該做到哪一層 |
|---|---|
| 部落格、內容站 | find + read 就夠(docs 頁品質最關鍵) |
| 工具站(計算機、轉檔) | 想讓 agent 直接算 → 再加 act(API/MCP) |
| SaaS、電商 | 需要 agent 登入、下單、付款 → act 全套,含 OAuth 與機器可讀的登入端點 |
至於那些最夯的協定,採用率低到會讓你冷靜一下:Ora 掃了約 10 萬個站,x402/MPP(agent 直接付款)與 MCP Apps 是 0 個正式部署,WebMCP 只有 1%,能讓 agent 安全登入的 OAuth metadata + PKCE S256 也只有 1%。反過來,最上面那幾個都是「寫一個靜態檔、放在固定路徑、結束」——採用率幾乎完美對應摩擦係數。
所以現在該做的不是追新協定,而是把不用寫程式的那三件事做對。
常見問題 FAQ
AgentReady 是官方標準嗎?
不是 W3C 那種標準。它是一份開放規格(MIT、GitHub 公開),由 Ora 主導,Vercel、Stripe、Auth0、Mintlify 等公司協作。有份量,但仍是產業自發的規格。
它跟 GEO 是同一件事嗎?
不是。GEO 是「被 AI 找到並引用」,屬於 find 那一層。AgentReady 還包含 read(讀不讀得到)與 act(能不能完成任務)。
我一定要接 MCP 嗎?
不用。除非你要讓 agent 替你完成交易或操作。內容站把 find/read 顧好,分數就會明顯上來。
掃描分數低代表網站有問題嗎?
不代表網站壞了,代表「對 agent 不夠友善」。我的主站 60 分,一般使用者瀏覽完全正常——這是兩套標準。
我要怎麼知道 AI 真的有沒有來?
看伺服器日誌,比對 OpenAI/Anthropic 公布的爬蟲 IP 範圍。用 UA 字串測只能當粗略參考。
延伸閱讀
- AI 開始「用」你的網站了:WebMCP 是什麼?跟 GEO 差在哪?
- MCP 到底該不該用?Simon Willison 的「致命三要素」判斷法(附檢查清單)
- AI 省了寫的時間,卻花了讀的時間:1 個框架讓你的 AI 產出第一次就對
結語
我們花了兩年學會「讓 AI 找到你」,接下來要學的是「讓 AI 用得到你」。
而在這件事上,最難的其實不是技術,是願不願意去看自己的分數。我這次掃完的結果不好看——主站 60 分——而且掃的過程還挖出一個我完全不知道的問題:sitemap 壞了。修好之後我重新驗證,地圖回來了(154 個 URL,三個 AI 爬蟲都拿得到)。
如果你也有網站,建議先做一件事:把 robots.txt 打開、把 sitemap 點一次、確認它沒壞。這三個動作花不到十分鐘,但它是 agent 認不認識你的第一步。
(本文規格與數據來源:AgentReady 官方規格、Ora 的 agent readiness 研究、Ora 的 AgentReady 發布說明;掃描結果為 2026-10-23 以 is-agentic.com CLI 實測。)
5 個省錢策略,從月費 NT$2,200 → NT$660 👇
🔒 填寫即訂閱雙週報,可隨時退訂。下載連結將寄到你的信箱。